Problemas atuais de thread e memória do LLMs
Dois meses dentro de uma única thread de chat com um assistente de IA, pedi uma pequena edição. Algumas palavras. Ela consumiu um quarto da minha cota da sessão.
Nada estava quebrado. Eu tinha simplesmente esbarrado no jeito como a ferramenta funciona, e vale a pena entender isso antes de decidir como organizar a sua prática em torno dela.
Por que um pedido pequeno pode custar uma fortuna
Uma thread de chat não tem memória no sentido humano. A cada turno, o assistente relê a conversa inteira desde o início e só então responde. O custo de uma mensagem, portanto, não é o tamanho do seu pedido. É o tamanho de tudo o que veio antes, mais o pedido.
Minha thread tinha crescido por dois meses. Cada pergunta que eu fazia (por exemplo, “corrija esta vírgula”) custava um monte de tokens de releitura antes que o assistente produzisse uma palavra. O pedido era pequeno. O contexto não era, e o pedido herdou isso.
Eu tinha ouvido o folclore: comece uma thread nova de vez em quando, porque um chat se degrada e custa cada vez mais tokens à medida que cresce. Eu fazia isso todo mês, pedindo ao assistente um documento de transição (handoff) e abrindo uma conversa nova. Resolvi testar se era mesmo necessário pulando uma vez. Confirmou que era.
E então veio a solução proposta automaticamente: subir de plano ou comprar mais tokens.
A leitura de fatores humanos
Deixe a questão do preço de lado por um momento e olhe para isso como uma interface.
Você tem um recurso que se esgota. Ele se esgota de forma não linear, porque o custo de cada ação cresce com o estado acumulado. E esse estado é invisível. A interface de chat não mostra nenhum medidor. A versão de linha de comando mostra um contador subindo, sem teto, então você sabe que está gastando, mas não quanto ainda tem. Em certo momento, meu pedido estava consumindo 160.000 tokens, e eu não fazia ideia se isso era muito ou não.
Na maioria dos lugares em que trabalho, essa combinação seria reprovada na primeira revisão. Nenhuma visibilidade do estado. Nenhum feedback sobre o consumo. Nenhuma maneira de o operador construir um modelo mental preciso do sistema. Isso me lembra uma situação parecida em que, no Canadá, os planos de internet residencial tinham limites de download (não só os de celular). Acho que quase todo mundo já encarou pelo menos uma vez uma conta absurdamente alta, porque não havia como saber quanto tinha sido usado. Com tudo cobrado no fim do mês, a surpresa era amarga.
O resultado previsível é que o folclore começa a se acumular. Peça um handoff e comece uma thread nova todo mês. Use tais e tais skills. Escreva os prompts de tal e tal jeito. Basicamente, você tenta aprender o que consome e o que não consome. Lê fóruns para saber quais funções são caras. Cada um desses conselhos pode ser real e útil, e cada um deles é uma tarefa do produto empurrada para a pessoa que o usa.
Não estou dizendo que isso é um dark pattern, projetado para prender alguém. Contexto é uma limitação de engenharia sem solução, e as pessoas que constroem essas ferramentas sabem disso melhor do que eu. Mas não é preciso intenção para que um incentivo esteja desalinhado. Neste caso, a opacidade favorece o vendedor, e uma solução automática do tipo “faça upgrade” quando a correção real é “comece uma thread nova” mostra que o produto ainda não assumiu o problema.
As gambiarras trazem seus próprios problemas
O folclore então criou um segundo problema. Quando você alterna threads, cada uma acumula assuntos. Minha thread de marketing tinha conteúdo inbound, prospecção outbound, uma questão de autorização de cliente e uma discussão sobre ferramentas, tudo numa única rolagem. Tentei threads mais amplas para reduzir a rotação, e ficou pior: mais difícil de buscar, mais difícil de passar adiante, e o documento de handoff cresceu até ter o mesmo problema da thread.
Foi aí que ficou claro que a questão não era o tamanho da thread. Era que eu estava usando uma thread de chat como memória, e uma thread de chat é uma memória péssima. É linear, é cara de reler, mistura assuntos e pertence ao fornecedor.
O que construí no lugar
Parei de tratar threads como memória. O estado agora vive fora do chat.
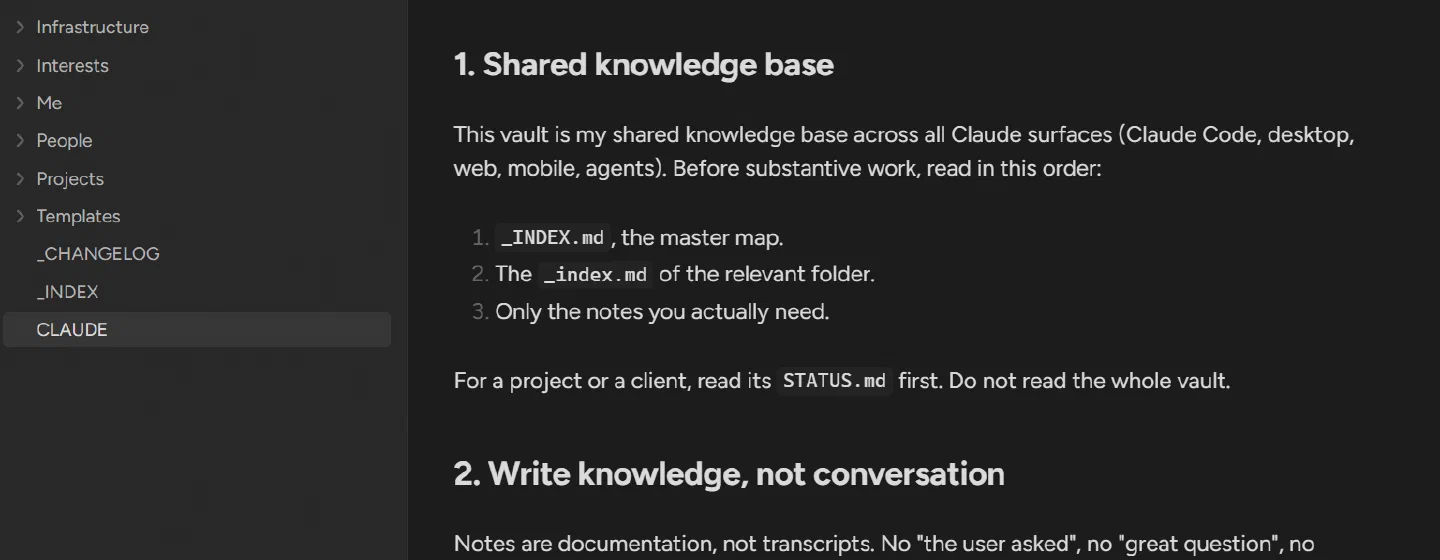
Concretamente: um cofre de notas em texto puro (markdown), um assunto por nota, guardado no Obsidian em um servidor doméstico que eu já mantenho. Um pequeno servidor MCP expõe o cofre ao assistente por meio de um túnel, de modo que qualquer superfície de IA pode ler e escrever nele. Um arquivo curto de regras dentro do cofre diz ao assistente como se comportar: ler o índice mestre e a nota de status relevante no início de uma sessão, escrever de volta fatos e decisões no fim, registrar cada edição em um changelog, nunca escrever conteúdo de chat, um assunto por nota, e colocar qualquer coisa incerta numa pasta de entrada com uma localização proposta.
As threads viraram sessões. Abro uma para um trecho de trabalho, o assistente lê alguns milhares de tokens de cofre em vez de cento e sessenta mil tokens de histórico, fazemos o trabalho, ele escreve de volta o que mudou, e a thread pode morrer. A próxima sessão começa a partir do cofre, não de um handoff.
Os benefícios secundários acabaram importando tanto quanto a economia de tokens. O cofre é versionado, então consigo ver o que mudou e quando. Tem backup. É portátil, então posso trocar de ferramenta ou apontar duas ferramentas para o mesmo trabalho. E é meu, num formato que ainda vai abrir daqui a vinte anos.
O que isso custa
Realmente não é uma solução perfeita, principalmente do jeito como as ferramentas são projetadas hoje.
Não é uma solução para o consumidor comum. Exigiu um servidor doméstico, um túnel Cloudflare, uma tarde com um agente de programação para ligar o servidor, e disposição para manter infraestrutura. A maioria das pessoas não deveria fazer isso, e o fato de que teriam que fazer é o ponto central da primeira metade deste artigo.
Depende de disciplina. Um cofre em que ninguém escreve de volta decai até virar um espelho desatualizado do mundo, o que é pior do que não ter cofre, porque você confia nele. O arquivo de regras ajuda. O assistente segue bem. Mas a etapa de escrever de volta é um hábito, e hábitos falham.
As threads começaram a se multiplicar muito mais rápido, e no fundo não estou mais usando a ferramenta de chat como ela foi pensada. O contexto que cada thread constrói duplica o cofre, e as muitas threads curtas criadas para contornar o problema deixam para trás uma pilha de chats inutilizáveis. O histórico de chats vira uma ferramenta sem uso, que agora é só uma distração.
O que eu gostaria de ver no produto
Primeiro, previsibilidade. Não precisa ser perfeita, mas precisamos de uma ideia do que vai ser consumido. Isso não deveria ser difícil de construir, já que as ferramentas de IA já sabem quando compactar, e sabem como isso afeta o consumo de tokens. Não precisamos de um painel de uso enterrado nas configurações. Precisamos de um indicador visível de quanto custa continuar esta thread, bem ali onde a mensagem é digitada. Esse único elemento teria substituído o folclore para mim.
Segundo, uma separação nativa entre sessão e estado. As peças existem, projetos, recursos de memória e assim por diante, mas ainda pertencem ao fornecedor e continuam opacas. O padrão que construí à mão é para onde essas ferramentas estão indo. Eu só gostaria que ele chegasse numa forma que não exigisse um servidor no meu porão.
Até lá, o cofre segura. Ele colocou o medidor de volta onde consigo vê-lo, e fez minhas ferramentas pararem de esquecer o que importa.
Sobre o autor
Louis-Philippe Bellerose
Fundador e Consultor Principal